Bot-Schutz und verifizierte Crawler in X Shield
Wird X Shield Googlebot blockieren?
Nein. X Shield lässt Googlebot in Ihren Shopify-Shop, solange Googlebot unter Globale Umgehung → Bekannte Bots angehakt ist, was standardmäßig der Fall ist. Es prüft die Adresse jedes Crawlers gegen die IP-Bereiche, die Google, Bing, Apple, DuckDuckGo, OpenAI, Anthropic und Perplexity veröffentlichen, oder sein Netzwerk bei Meta, Ahrefs und Yandex. Bei eingeschaltetem Bot-Schutz werden gefälschte Googlebots blockiert.
Ein angehakter Crawler, der diese Prüfung besteht, umgeht jeden Schutz, sodass das Blockieren eines Landes die Google-Indexierung Ihres Shops nicht stoppt.
Was blockiert der Bot-Schutz?
Automatisierte Besucher, die das JavaScript Ihrer Storefront ausführen und nicht auf Ihrer zugelassenen Liste stehen. Um ihn einzuschalten, schalten Sie Bot-Schutz unter Zugriffskontrolle in der Übersicht ein; ein Toast sagt Funktion aktiviert. Alle aktivieren im Einrichtungsassistenten macht dasselbe. Er ist heute auf jedem Tarif enthalten (Tarife vergleichen).
| Details in Analysen | Was X Shield gesehen hat |
|---|---|
Bot detected (NA): … |
Ein verifizierter Crawler, den Sie unter Bekannte Bots nicht angehakt haben |
Bot detected (SP): … |
Ein Besucher, der den Namen eines Crawlers vortäuscht, von einer Adresse, die nicht die des Crawlers ist |
Bot detected (IP): recognised crawler, not allowed |
Ein an seiner Adresse erkannter Crawler, den Bekannte Bots nicht zulässt |
Bot detected (UA): … |
Ein Client, dessen User-Agent nicht der eines Browsers ist |
Bot detected (AT): … |
Ein Automatisierungswerkzeug, das sich nicht verbirgt |
Prüfung anfordern auf dem Bildschirm Blockierungsseite gibt Besuchen mit (SP), (UA) oder (AT) stattdessen eine kurze Prüfung, ob sie Menschen sind (Besucher verifizieren lassen).
Hinweis: Der Bot-Schutz arbeitet im Browser des Besuchers. Clients, die nie das JavaScript Ihrer Seiten ausführen, wie curl, python-requests, Scrapy und die meisten KI-Crawler, erhalten Ihr HTML trotzdem, Daten-Endpunkte wie
/products.jsonwerden nie geprüft, und ein gut getarnter Headless-Browser kann durchkommen. Shopifys Theme-Thumbnails und die Lighthouse-Audits von PageSpeed Insights werden durchgelassen.
Welche Crawler erkennt X Shield, und wie?
Zehn Crawler-Familien, gelistet unter Globale Umgehung → Bekannte Bots. Jede wird an ihrer Adresse verifiziert, anhand der vom Anbieter veröffentlichten IP-Bereiche oder ihres Netzwerks (ASN), nie allein am User-Agent. Google beschreibt den Abgleich der IP-Adresse eines Crawlers mit seinen veröffentlichten Bereichen als eine Möglichkeit, Googlebot zu verifizieren.
| Eintrag unter Bekannte Bots | Deckt ab | Verifiziert durch | Standard |
|---|---|---|---|
| Googlebot | Googlebot, Google-InspectionTool, Storebot-Google, AdsBot-Google und andere Google-Crawler | Veröffentlichte IP-Bereiche | Zugelassen |
| Bingbot (Microsoft) | bingbot, BingPreview, AdIdxBot | Veröffentlichte IP-Bereiche | Zugelassen |
| Applebot | Applebot | Veröffentlichte IP-Bereiche | Zugelassen |
| DuckDuckBot | DuckDuckBot, DuckAssistBot | Veröffentlichte IP-Bereiche | Zugelassen |
| Meta (Facebookbot) | facebookexternalhit, meta-externalagent und andere Meta-Crawler | Netzwerk (ASN) | Zugelassen |
| OpenAI (GPTBot, ChatGPT) | GPTBot, ChatGPT-User, OAI-SearchBot | Veröffentlichte IP-Bereiche | Blockiert |
| Claude (Anthropic) | ClaudeBot, Claude-User, Claude-SearchBot | Veröffentlichte IP-Bereiche | Blockiert |
| Perplexity | PerplexityBot | Veröffentlichte IP-Bereiche | Blockiert |
| AhrefsBot | AhrefsBot, AhrefsSiteAudit | Netzwerk (ASN) | Blockiert |
| YandexBot | YandexBot, YaDirectFetcher | Netzwerk (ASN) | Blockiert |
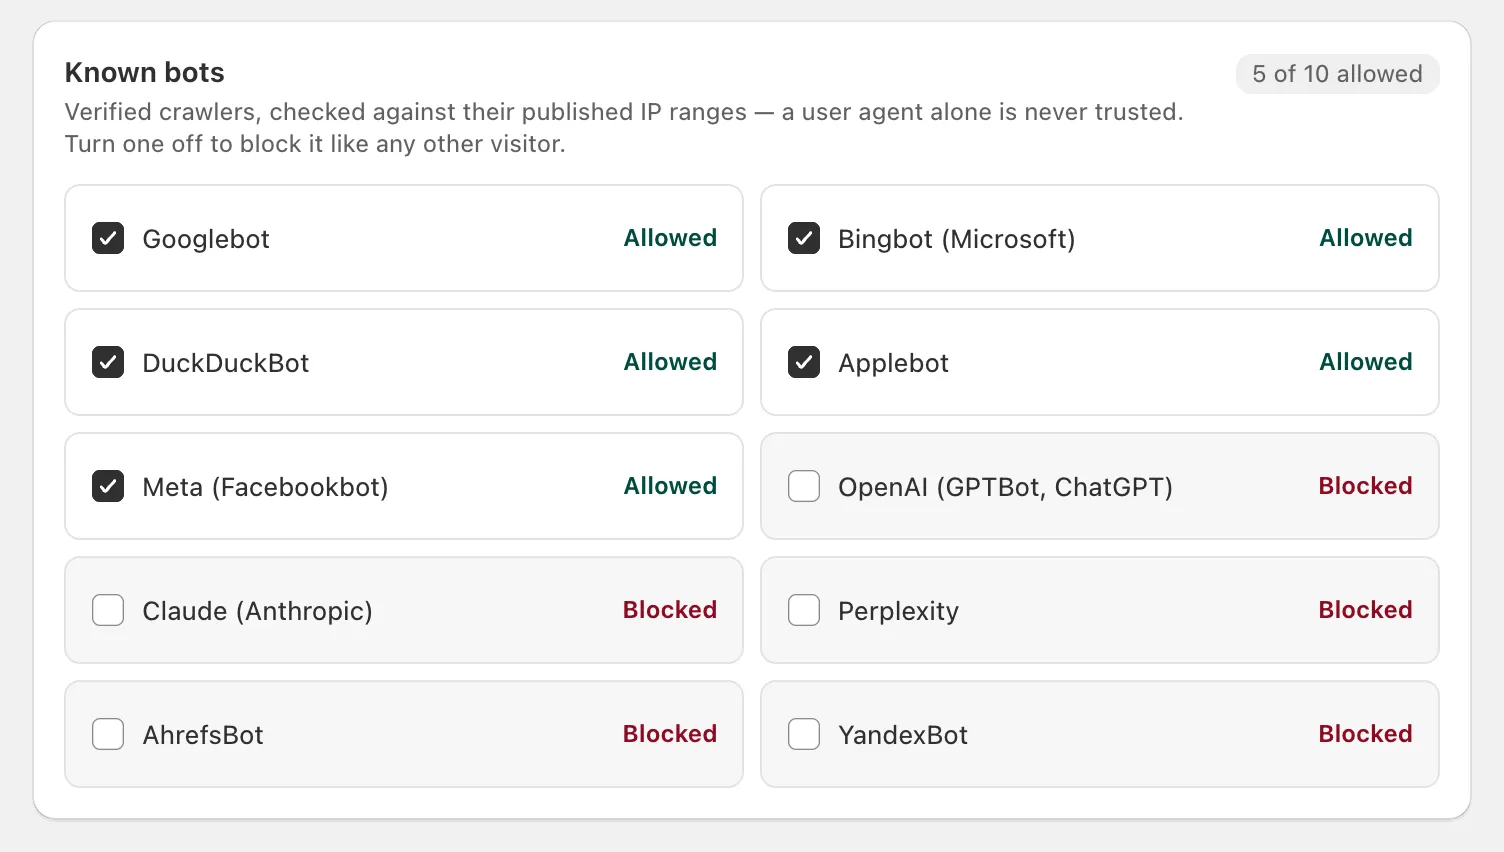
Um die Liste zu ändern, haken Sie einen Eintrag an oder ab und klicken Sie auf Save. Ein nicht angehakter Crawler erhält keine Umgehung: Bei eingeschaltetem Bot-Schutz wird er blockiert, und Ihre übrigen Regeln behandeln ihn wie jeden Besucher. Crawler, die keine IP-Bereiche veröffentlichen, die X Shield prüfen kann, wie Pinterestbot, Amazonbot und ByteDances Bytespider, lassen sich nicht verifizieren und können nicht hinzugefügt werden.
Was passiert mit einem Bot, der sich als Googlebot ausgibt?
Bei eingeschaltetem Bot-Schutz wird er blockiert. Sagt der User-Agent eines Besuchers Googlebot, seine Adresse liegt aber nicht in Googles Bereichen, behandelt X Shield ihn als Fälschung, zeigt die Blockierungsseite und zeichnet Bot detected (SP): … in Analysen auf.
Bei ausgeschaltetem Bot-Schutz behandeln Ihre Land-, IP- und Netzwerkregeln einen gefälschten Crawler wie jeden Besucher. Der Bot-Schutz blockiert einen Crawler nie nur deshalb, weil X Shields eigene IP-Abfrage fehlgeschlagen ist.
Sollte ich KI-Crawler wie GPTBot und ClaudeBot zulassen?
Haken Sie sie an, wenn Sie möchten, dass KI-Suche und -Assistenten Ihre Seiten lesen; lassen Sie sie unangehakt, wenn Sie das lieber nicht möchten. Sie sind optional: OpenAI (GPTBot, ChatGPT), Claude (Anthropic) und Perplexity starten unangehakt, sodass X Shield sie bei eingeschaltetem Bot-Schutz blockiert, wenn sie das JavaScript Ihrer Seiten ausführen.
Die meisten KI-Crawler führen nie JavaScript aus, sie erhalten also Ihr HTML, egal was Sie ankreuzen. Um sie zu bitten, fernzubleiben, lässt Shopify Sie robots.txt bearbeiten, auch wenn Shopify darauf hinweist, dass diese Regeln beratend sind und nicht jeder Crawler sie befolgt. Shopify weist auch darauf hin, dass das Blockieren von KI-Crawlern nur die Auffindbarkeit im offenen Web betrifft: Produktdaten, die Sie mit agentenbasierten Storefronts teilen, erreichen diese über den Shopify Catalog so oder so.
Blockiert X Shield die Crawler von Facebook und Instagram?
Nicht standardmäßig. Meta (Facebookbot) ist in der Liste Bekannte Bots vorab angehakt, sodass Link-Vorschauen auf Facebook, Instagram, WhatsApp und Messenger sowie Instagram Shopping weiterhin funktionieren.
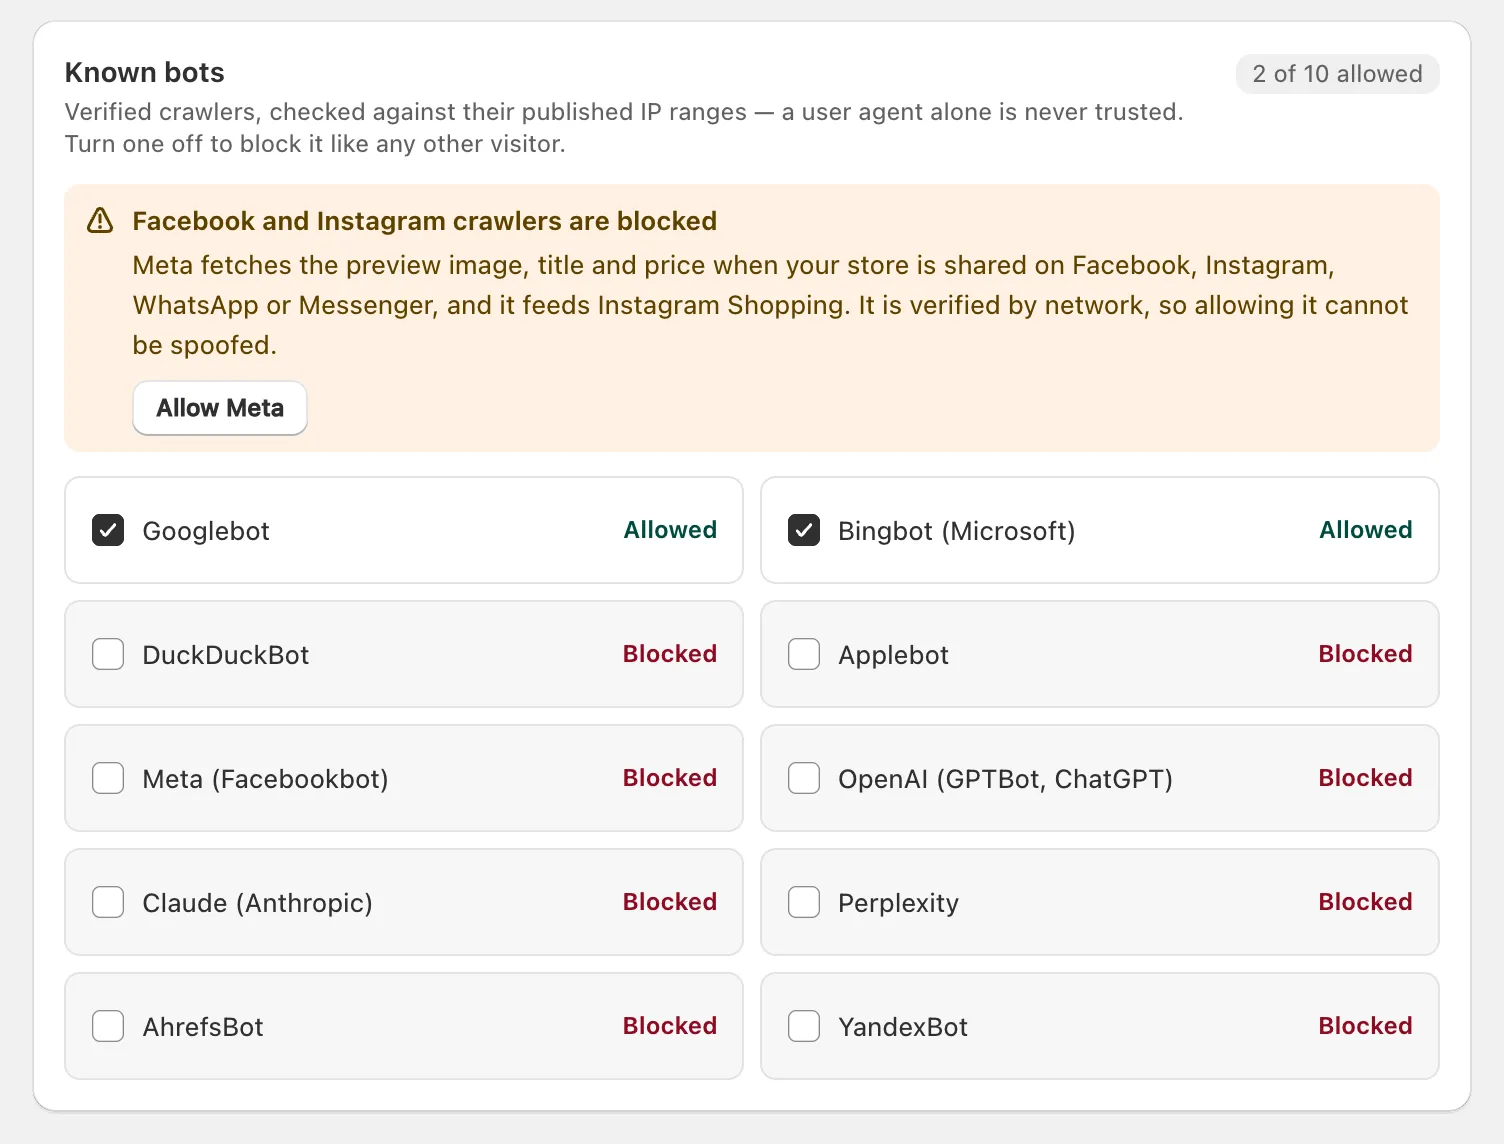
Ist Meta (Facebookbot) in Ihrem Shop nicht angehakt, erscheint unter Globale Umgehung die Warnung Facebook- und Instagram-Crawler werden blockiert. So erlauben Sie Meta wieder:
- Klicken Sie unter Globale Umgehung in der Warnung auf Meta erlauben, oder haken Sie Meta (Facebookbot) an.
- Klicken Sie auf Save.
Was, wenn ein Crawler die Blockierungsseite trotzdem erreicht?
Die Blockierungsseite weist Suchmaschinen an, sie nicht zu indexieren (noindex,nofollow), sodass diese URL aus Googles Ergebnissen verschwinden kann, statt „Access denied” zu zeigen. Das passiert, wenn Sie Googlebot abhaken, oder bei Crawlern, die X Shield nicht verifizieren kann.
Googlebot angehakt zu lassen bedeutet, dass Google Seiten sieht, die Ihre blockierten Besucher nicht sehen können. Googles Anleitung für Seiten, die sich je nach Standort ändern, lautet, Googlebot wie jeden Besucher aus dem Land zu behandeln, aus dem er zu kommen scheint, und Googlebots Standardadressen scheinen in den Vereinigten Staaten zu liegen. Blockieren Sie die Vereinigten Staaten, lesen Sie zuerst schadet das Blockieren von Ländern der SEO?
Wie prüfe ich, dass Google meinen Shop noch crawlen kann?
Führen Sie einen Live-Test in der Google Search Console durch. Der Screenshot sollte Ihren Shop zeigen, nicht die Blockierungsseite.
- Prüfen Sie in der Search Console eine Ihrer Produkt-URLs mit dem URL-Prüftool.
- Klicken Sie auf Test live URL.
- Klicken Sie auf View tested page und öffnen Sie den Tab Screenshot.
Der Live-Test nutzt Google-InspectionTool, das X Shield unter Googlebot verifiziert. Auf bezahlten Tarifen listet Globale Umgehung außerdem Letzte Umgehungen, wo verifizierte Crawler-Besuche als Verifizierter Crawler erscheinen.
